丹棱君有话说:今天的“我在微软做研发”栏目,丹棱君要为大家介绍一位信仰语音技术的“老男孩儿”。他操着一口流利的湖南普通话,带着团队实现了“达到人类专业水平”的语音识别技术;他在 2016 年被 Wired 杂志评为全球创造未来商业的 25 位大牛天才之一,还在不久前当选“微软全球技术院士”。他就是我软的老将黄学东。想知道他在一个领域攻关几十年是什么感受吗?花上五分钟,细细品味这篇文章,你值得拥有!
黄学东,微软语音识别技术 24 年老将,IEEE/ACM 双科院士,微软深度学习工具包 CNTK 的缔造者之一。1993 年加盟微软之前,他在卡内基梅隆大学计算机学院工作,目前领导包括微软在美国、德国、埃及、以色列的全球团队负责研发微软企业人工智能客服对话解决方案 、cris.ai 和 luis.ai 等认知服务、CNTK 开源深度学习工具等最新人工智能产品和技术。他在英国爱丁堡大学 、北京清华大学 、长沙湖南大学分别获得博士、硕士、学士学位。他是母校湖南大学软件学院名誉院长和名誉教授。2016 年 Wired 杂志评选他为全球创造未来商业的 25 位大牛天才之一。2017 年 2 月,黄学东当选微软全球技术院士,进一步奠定了自己在微软的技术领袖地位。
很少有人知道,微软全球技术院士(Technical Fellow)代表着微软技术人员的最高荣誉,目前为止,全球仅有约二十位人获得,其中包括图灵奖得主 Butler W Lampson、Charles P. Thacker 等。微软全球技术院士相当于微软的 level-80,与全球资深副总裁同级别。黄学东是首位在微软通过技术路线走到最高层的华人。
2017 年 2 月,黄学东接受新智元专访,用带着湖南口音的普通话,聊到了微软语音技术去年最耀眼的成就 —— 对话语音识别词错率低至 5.9% 背后的故事。他介绍,10 个神经网络 + CNTK 强大的速度成就了这一“工程上的奇迹”。
人类水平的语音识别始末
2016 年 9 月 14 日,由黄学东带领的微软语音团队在产业标准 Switchboard 语音识别基准测试中实现了对话语音识别词错率(word error rate, 简称 WER)低至 6.3% 的突破 ,创造当时该领域内错误率最低纪录。仅仅一个月后的 10 月 18 日,黄学东团队进一步将词错率降低至 5.9%,首次达成与专业速记员持平而优于绝大多数人的表现。这被认为是人工智能领域 2016 年最大的突破性进展之一。
微软首席语音科学家黄学东博士表示,“在对话语音识别中,我们已经实现了和人类同等的水平,这是一个历史性的突破,意味着有史以来第一次有计算机能像人类一样识别对话中的每一个单词。”
微软语音团队花了不到一年时间就实现了这个目标,这远远超出大家的期望。黄学东认为,这一里程碑是在整个语音团队的努力以及沈向洋全球执行副总裁领导下取得的,也离不开整个 AI 技术研究领域多年的积累。
值得注意的是,微软宣布的此项研究成果,是基于英文的。那么,中文和英文有着完全不同的语法结构,对它们的语义理解哪个可能最先突破呢?黄学东表示,从语音识别的角度来讲,中文识别更容易,中文只有四百个音节。微软内部用同样的技术分别评测中英文,中文识别率要高一些。在所有语言里面,意大利文、西班牙文、中文,这三种语言,语音识别率比法文、英文之类要高,其中法文是最难的。然而语义理解对任何语言都很难,这是最有挑战的课题。
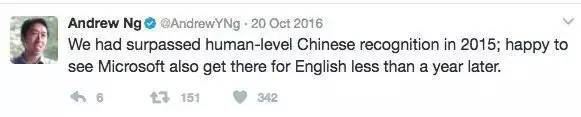
记得 2016 年 10 月 18 日,在微软官方宣布这一消息后,百度首席科学家吴恩达发了一条推特:“我们在 2015 年已经实现了超过人类水平的中文(语音)识别,很高兴看到微软在不到一年之内就在英文上也达到了相同水平。”
“达到人类水平”一直被众多公司用来直观呈现自己的人工智能技术发展水平,具体到语音识别领域,百度早在 2015 年就宣布,中文语音识别准确率已经超过人类水平,2015 年底百度的 Deep Speech 短语识别的错误率降到了 3.7%。
针对这一评论,黄学东认为,还是需要澄清短语识别错误率和对话式语音识别错误率的不同,“可以说,这两个指标没有太多可比性。”
黄学东说:“我们说人工智能达到人的水平,要讲在什么样的任务下可以达到人类水平。简单的任务,容易达到人类水平;困难的任务例如对话识别,整个语音界为此努力了二十多年,在这样难度很高的识别任务中能够达到人类水平,是一个重要的里程碑!”
同时,黄学东认为,评测的数据集对其最后结果的解读也会产生不一样的影响。根据官网,Switchboard 的数据是包括了大约 2400 个自然情形下的对话,包含了各种年龄阶段、覆盖了美国主要的一些地方口语。这是一个公认的数据集。在这样的数据集下,计算机做到跟人一样的水平是很不容易的。
那么,从技术上来说,黄学东团队“达到人类水平” 的语音识别技术,是如何实现的呢?
10个不同的神经网络组合,造就“工程的奇迹”
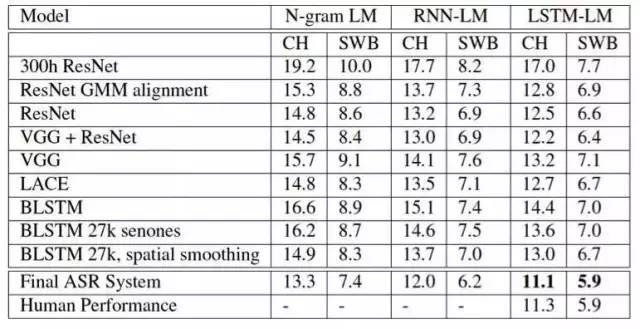
黄学东说:“达到人类水平的对话语音识别,与其说是算法的胜利,不如说是‘工程的奇迹’。”
微软一项著名的技术——深度残差网络,在黄学东团队的语音识别技术中发挥了重要作用。他说,事实上,这个人类水平的对话语音识别系统用到了 10 个不同的神经网络。基本上我们能想到的神经网络,他们都用了。通过 10 个神经网络合力得出最佳结果。所以,这可以称得上是“一场工程的奇迹”。
具体的过程是:首先是用 6 个不同的神经网络组合并行工作,包括了残差网络、LSTM 等,最后的结果再通过 4 个新的神经网络再组合之后输出,最终获得达到了人类水平的对话语音识别结果。
据黄学东介绍,在这个模型中,每个神经网络首先分别用长达 2000 小时的数据单独训练,每个系统具有超过 2 万个 senone。其中 CNN 单独训练的效果最出众。在这些神经网络中,包括了 3 个 CNN 的变种:
第一个是 VGG 网络,相比用于图像识别的 VGG,这个用于语音识别的 VGG 网络更深;
第二个是残差网络,在微软亚洲研究院用残差网络在 ImageNet 上取得好成绩的时候,语音团队也引入了残差网络;
第三个是 LACE,是 TDNN 的变种,每一个高层次是一系列低层次的非线性变换的加权总值。
紧随其后的是 LSTM 的单独表现。黄学东团队发现,超过六层的神经网络不能改善词错率,而对于每一个方向的每一个层,选择 512 个隐藏单位,是对于训练时间和精确度的最佳平衡。
他也提到,整个训练过程主要是监督学习。并且他们最终上线的产品实际训练数据不仅仅是 Switchboard 数据集,训练时间也远远超过 2000 小时。目前该项研究成果已经用在了如小冰、Cortana、Customize Speech Service 等语音产品。因为商用的语音识别需要的计算资源更多,所以小冰和 Cortana 实际上用的是简化版的模型。
功臣——CNTK

如此复杂的工程,微软在不到一年的时间完成并取得很好效果。黄学东认为 CNTK 功不可没,尤其是,CNTK 在 LSTM 的训练速度是其它主流开源框架的 5 倍到 10 倍。
CNTK 是黄学东团队在研究过程中开发的一个开源深度学习工具包,现在不仅仅是语音团队,图像、自然语言处理、医疗服务等团队都在使用这个工具。
据介绍,CNTK 具有灵活的模型定义,同时能够有效地扩展到多个 GPU 和多个服务器。即使长达 2000 个小时的语料库,CNTK 也能以很高的性能应对这样的训练挑战。同时 CNTK 中既可以使用自定义的函数语言 BrainScript,也可以用 Python。
黄学东说微软的内部工程需要很多数据来训练,做了很多的优化,因此 CNTK 非常快。这也是他们迅速训练出达到人类水平语音识别 AI 的关键因素。
现在 CNTK 已经是最受欢迎的开源框架之一,难免被拿出来跟其它几个开源框架比较,例如 TensorFlow、Caffe、MXNet、Torch 等。大家一提到开源框架,可能更多的人想到 TensorFlow。
黄学东说,关于开源深度学习框框,少有人知的两点事实是:

第一,CNTK 比谷歌的 Tensorflow 更早开源,但是它一开始不是在 GitHub上,所以了解的人也少;CNTK 当初的主要目标是服务微软人工智能的各种大数据的训练任务,他们在开源出来的时候还不知道谷歌也会做同样的事情。
第二,CNTK 的性能可能是最好的。根据香港浸会大学对五大开源框架的性能测试,CNTK 在小型 CNN 上表现一流,对于带 LSTM 的 RNN,CNTK 速度最快,比其他工具好上 5 到 10 倍,可谓全面超越其它工具。多 GPU 卡环境下,CNTK 平台在 FCN 和 AlexNet 上的可扩展性更好。
黄学东说:“TensorFlow 当然也有很多值得我们学习的地方,它的生态系统比我们好。严肃的人工智能是需要大数据来学习的,微软的工具 CNTK 在大数据学习上是超一流的。”
黄学东还表示,CNTK 2.0 RC1 三月初一定会和大家见面。CNTK 2.0 会充分扩展 TensorFlow 的基本功能让我们的用户有更有效的选择。所以用户在选择哪一个工具将来也许不是那么重要了。因为不同的模型都可以通过 keras 或者模型转换器互相转换。比如 CNTK 2.0 将会提供 caffe 和CNTK 的转换器。TensorBoard 是谷歌的可视化工具,它也可以用来可视化 CNTK。
下一步:谁能实现语义理解,谁就实现了强人工智能
黄学东介绍说,目前的语言模型难以迁移到不同的任务,通过大量正确的数据解决这一问题有一定的效果。但是究其本质,迁移问题是由于目前的语言模型缺乏语言学“头脑”,无法准确理解语义。另外,它们也不能考虑篇章结构,仅仅只涉及局部词语搭配。
同时,在一些人类听者听来难度很低或毫无难度的细微偏差,会让现有的语音识别系统的性能大幅下降。比如实际场景中可能的各种噪音,“或者是”,黄学东说,“我的湖南口音,都会使语音识别率大幅下降。人可以很快适应各种环境下的语音,机器却不能。”
黄学东也坦白说,微软的系统虽然在 Switchboard 上达到人类水平,但也不能说明在平时的应用中能达到人类水平。
黄学东认为,语音识别基本解决了,只要有足够的计算资源、有足够多的场景数据就可以做得很好。下一步,是要做好语义理解。谁能实现语义理解,谁就实现了强人工智能。
他提到了语言理解中比较有前途的一些技术方向,例如 LSTM + Attention Model + 大数据。把传统的符号系统和现代的概率系统有机的结合,是语言理解重要的研究方向之一。
黄学东说,在六七十年代传统 AI 都是符号逻辑、专家系统,直到八十年代人工智能的冬天,这些都快销声匿迹了。后来通过贝叶斯统计方法再次获得新生。为什么说下一个浪潮是两者从算法和工程上的有机结合?因为获取知识一定要理解语言,要理解语言又需要知识。在学习过程中,这两者是紧扣的。LSTM和“Attention Model”都是人们对 RNN 的改良,其中 Attention Model 是指神经网络在执行任务时知道把焦点放在何处,让神经网络在每一步都从更大的信息集中挑选所关注的信息作为输入。
黄学东认为另一个重大突破点在于怎么样把知识图谱和语言理解有机的结合起来。知识图谱包含了大量的世界知识,实体链接是实现了文本到知识的连接,是基于知识的文本语义理解的基础技术。黄学东认为,关键是要把两者结合起来用深度学习方法和外部存储指导深入学习的训练,目前还没有学会怎么样有效地利用这些。
“如果计算机理解了语言,那才是真正的突破,这就是强人工智能了,它可以二十四小时学习,大大超过人类的学习效率”,黄学东说。关于微软在语言理解方面的进展,黄学东也表示,现在任务艰巨,正在努力。
语音识别的四十年,CMU语音天团的传承
“语音识别的发展有四个阶段。”黄学东说,“第一个阶段,从孤立短语开始应用;第二个阶段,做成连续的,但是中间字和字需要停顿;第三个阶段是李开复当时博士论文做的,可以识别连续的语音,是人和机器交流,不需要训练;第四个阶段,对话式的语音识别早在二十多年前就已提出,其错误率一直徘徊在 30% - 50% 之间,直到最近几年才有突破性进展。”
这四个阶段,横跨了语音识别探索四十余年的艰辛与梦想。
1971 年,由 Allen Newell 领导的语音识别研究小组建议引入更多知识来源,他的报告讨论了六个层次的知识:声学、参量、音素、词汇、语句和语义。DARPA 资助的各种语音理解系统,正是为了实现 Newell 报告的目标。得到资助的研究小组不多,黄学东导师 Raj Reddy 1976 年在 CMU 领导的小组是其中之一。
1982 年,黄学东在清华读研究生,那是他涉足语音识别领域的开始。他说:“大家看到更多的是我在 CMU 和微软的成就,但是我不会忘记我的母校清华和湖南大学的功劳,是清华把我带入语音技术领域。是湖大帮我打下追求科学和工程的坚实基础。”

此后,黄学东先后进入英国爱丁堡大学和 CMU 继续语音识别的研究。在 CMU 他加入 Raj Reddy 的学生李开复(前微软全球副总裁)负责的 Sphinx 项目。第一代 Sphinx 是最早演示话者无关语音识别的系统。李开复离开之后,黄学东成为第二代 Sphinx 负责人,并首次开源了该项目。1992 年研发的 Sphinx-II 在同年 DARPA 资助的语音基准评测中获得了最高的识别准确度,黄学东也因此于 1992 年获得了 Allen Newell 优秀研究奖章。值得一提的是 Allen Newell 也是来自 CMU 。微软全球资深副总裁洪小文也参与了 Sphinx 的开发和研究,也是非常著名的语音专家。
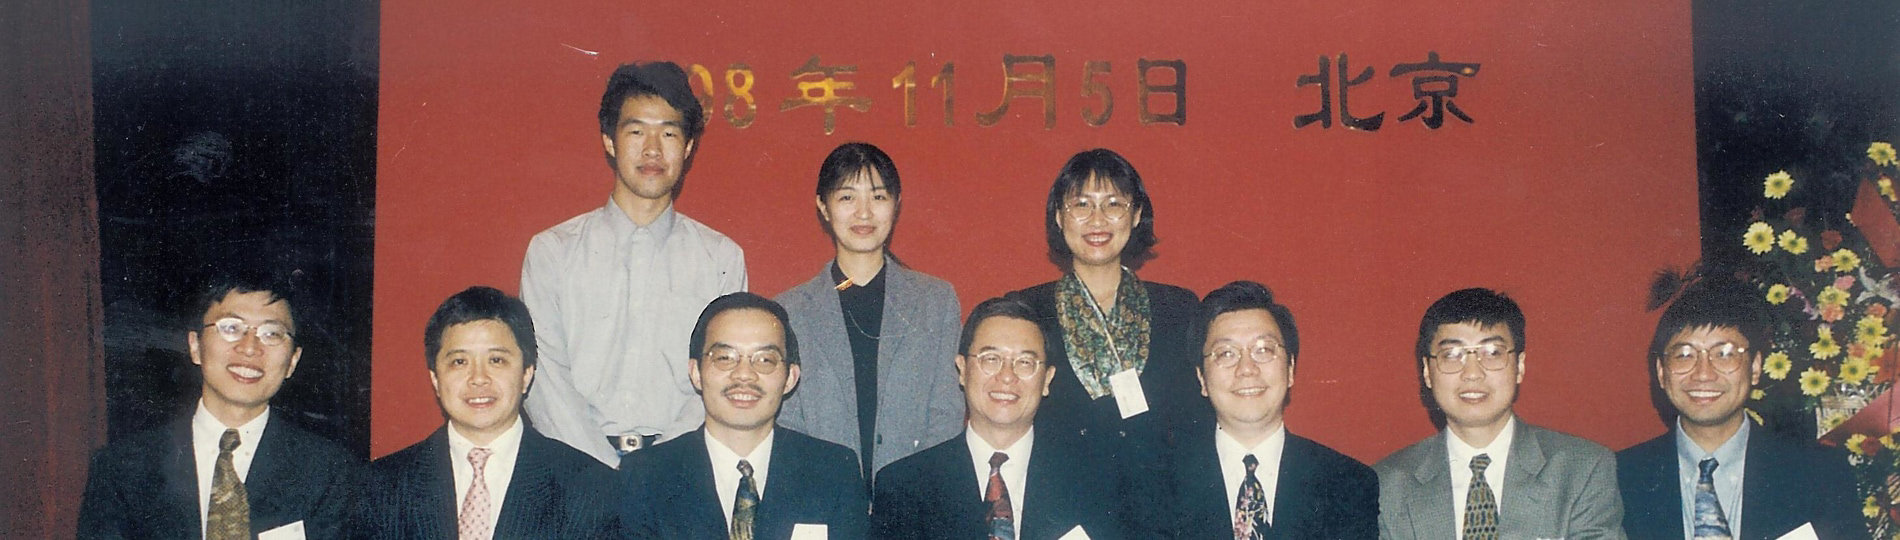
CMU 之后,黄学东于 1993 年加入微软。1995 年,数顾茅庐之后,黄学东最终把洪小文也拉入微软。此后黄学东几乎一直在微软研发语音识别技术,其间在 Bing 工作了一段时间,一直跟随微软全球执行副总裁沈向洋博士。当谈到他在同一个领域坚持攻关几十年的感受时,他说:
第一个感受是“脚踏实地”,语音多年来有很好的评测系统,这是没有办法忽悠的。做的东西是驴子是马,拿出来遛遛就知道了。
第二个感受是“创新”,也就是说,只要效果好,不管白猫黑猫都会上。语音识别是第一个用统计的方法取代了传统的人工智能专家系统的应用,也是第一个将深度学习和隐马科夫模型结合,成功大幅降低识别错误率的案例。深度学习在语音识别的应用推动了其他深度学习的成功,是微软研究院第一次把深度学习加入隐马尔可夫的方法。今天所谓的人工智能“三大法宝”:算法、算力、大数据,早在几十年前,做语音技术的人基本上最先注意到了这三个东西的重要性。
第三个感受是“坚持”。研究过程中,自然有很多困难,例如 90 年代在 Switchboard 上测试的错误率降不下来,机器不够用,跑的实验永远比机器多,学习训练的数据量不够大,缺乏同时具有人工智能深度知识和实践大型系统工程能力的专业人才等等。回过头来,有时才意识到,已经坚持了这么久。
第四个感受是“团队”。黄学东认为自己一直很幸运,有一群天才的队友在自己周围共同奋斗。团队的力量是最重要的力量。
如今,业界的普遍共识是,语音交互是下一代人机交互方式,国外有亚马逊 Echo 的热销,有微软在 Cortana 上的投入,有苹果在 Siri 上的投入,国内则有陆奇成立度秘事业部。李彦宏也曾在亚布力论坛上说:移动互联网是人与触摸屏的交互,到了人工智能时代,人机交互的方式会变成自然语言,带来很大变化。而语音识别技术可以说是语音交互之争的胜负关键手。
结语
黄学东这位微软“老男孩”,历经技术发展沉浮,依然对语音技术保持信仰。他相信未来 5 年,语音识别将通过图灵测试。这将真正使星际迷航般的移动设备愿景成为现实。他也认为语音识别和机器翻译技术可帮助缩小消除我们与机器之间的隔阂,大大促进和增强人与人之间沟通的强大工具。